Índice:
- Cluster de IA e o que definir antes do rack
- Aplicações e carga de trabalho orientam a escolha dos equipamentos
- Como dimensionar o rack, a energia e a distribuição elétrica
- Rede e armazenamento e o gargalo que aparece depois
- Refrigeração e localização definem a continuidade operacional
- Segurança, operação e crescimento do cluster
- Quando o projeto exige avaliação especializada
Um projeto de inteligência artificial costuma começar pela escolha das GPUs, mas essa é apenas uma parte da decisão. Quando a carga de processamento cresce, o rack precisa suportar mais energia, a rede deve transportar grandes volumes de dados e a refrigeração passa a ser uma condição para a continuidade, não apenas para o conforto térmico.
Planejar um cluster de IA para empresas significa relacionar aplicações, equipamentos, espaço físico, energia, conectividade, segurança e expansão. O objetivo é mostrar como estruturar essa análise, quem deve participar do projeto, quais riscos aparecem com frequência e como evitar que um investimento em desempenho crie um novo problema operacional.
Cluster de IA e o que definir antes do rack
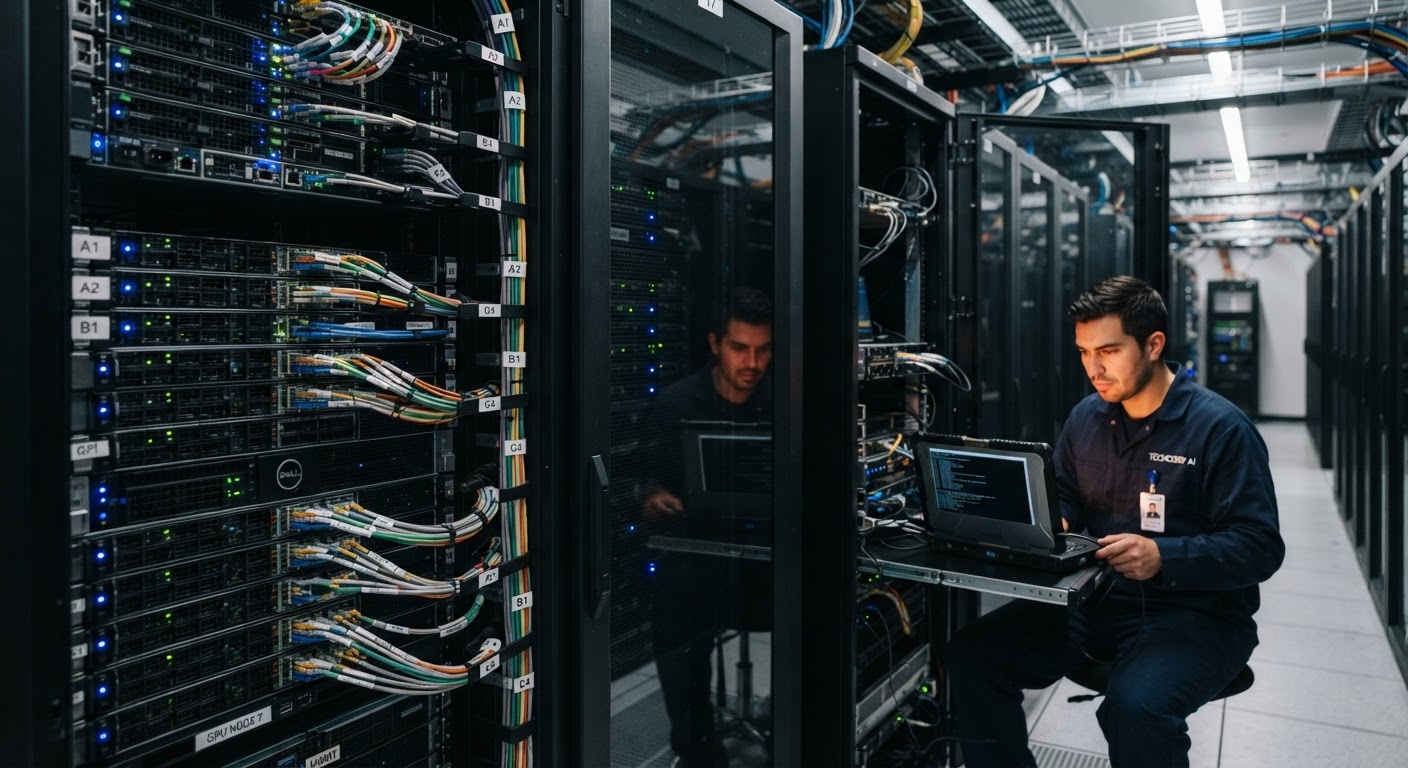
Um cluster de IA é um conjunto de servidores, aceleradores, armazenamento e redes interconectados para executar tarefas que exigem processamento paralelo, como o treinamento e a inferência de modelos. O dimensionamento correto começa pelo uso previsto. Um ambiente para inferência em horário comercial tem necessidades diferentes de uma infraestrutura dedicada ao treinamento contínuo de modelos.
A primeira conversa não deve ser sobre quantas GPUs cabem no rack. Antes disso, é preciso esclarecer quais aplicações serão executadas, qual volume de dados será processado, quantos usuários ou sistemas dependerão do serviço e qual tempo de resposta é aceitável. Também entram na análise a necessidade de manter os dados dentro da empresa, os requisitos de segurança e a expectativa de crescimento.
Um projeto desse tipo costuma envolver profissionais de infraestrutura, redes, segurança da informação, dados, aplicações e finanças. A área de negócio ajuda a priorizar os casos de uso. A equipe de dados descreve os modelos e volumes. Infraestrutura avalia energia, espaço e operação. Redes analisa tráfego e latência. Segurança define controles de acesso e proteção das informações. Finanças compara o investimento inicial com o custo recorrente.
Quando uma dessas perspectivas fica fora da decisão, o resultado costuma ser desequilibrado. Um servidor potente pode ficar subutilizado por falta de dados preparados, a rede pode virar o gargalo do treinamento ou o rack pode operar perto do limite térmico, sem margem para manutenção.
Aplicações e carga de trabalho orientam a escolha dos equipamentos
O mesmo cluster não atende da mesma maneira ao treinamento, ao ajuste fino, à inferência e ao processamento de dados. O treinamento costuma exigir comunicação intensa entre aceleradores e grande movimentação de dados. A inferência pode priorizar baixa latência, disponibilidade e capacidade para atender a várias requisições simultâneas. Já a preparação de dados pode pressionar mais o armazenamento e os processadores convencionais.
Essa diferença muda a composição do ambiente. Aceleradores, como GPUs, são escolhidos conforme a memória, o desempenho em operações específicas, o consumo elétrico e a compatibilidade com os frameworks utilizados. Porém, a quantidade de placas não determina sozinha o desempenho. Se os dados chegam lentamente ao servidor ou a comunicação entre nós é insuficiente, parte da capacidade computacional permanece ociosa.
Antes da compra, vale registrar uma linha de base da carga esperada, incluindo o tipo de aplicação, como treinamento, inferência, ajuste de modelos ou processamento em lote; o tamanho dos modelos, o volume de dados e a frequência de execução; o tempo de resposta desejado e a quantidade provável de requisições simultâneas; a memória necessária para os aceleradores, o armazenamento rápido e a retenção dos dados; além do nível de disponibilidade, da janela de manutenção e da previsão de crescimento.
Uma aplicação de visão computacional em uma linha operacional, por exemplo, pode exigir uma resposta rápida e previsível, enquanto o treinamento de um modelo pode ocorrer em períodos programados. Misturar essas cargas no mesmo desenho sem considerar as prioridades cria disputas por GPU, rede e armazenamento.
Também é preciso decidir se o processamento ficará centralizado em um único ambiente ou distribuído entre diferentes locais. Quanto maior a distância entre os servidores e os dados, mais atenção será necessária à latência, à banda disponível e à segurança do tráfego. A arquitetura pode ser local, híbrida ou apoiada por recursos externos, mas a decisão deve partir da aplicação e das restrições de dados, não apenas da preferência por um tipo de equipamento.
Como dimensionar o rack, a energia e a distribuição elétrica
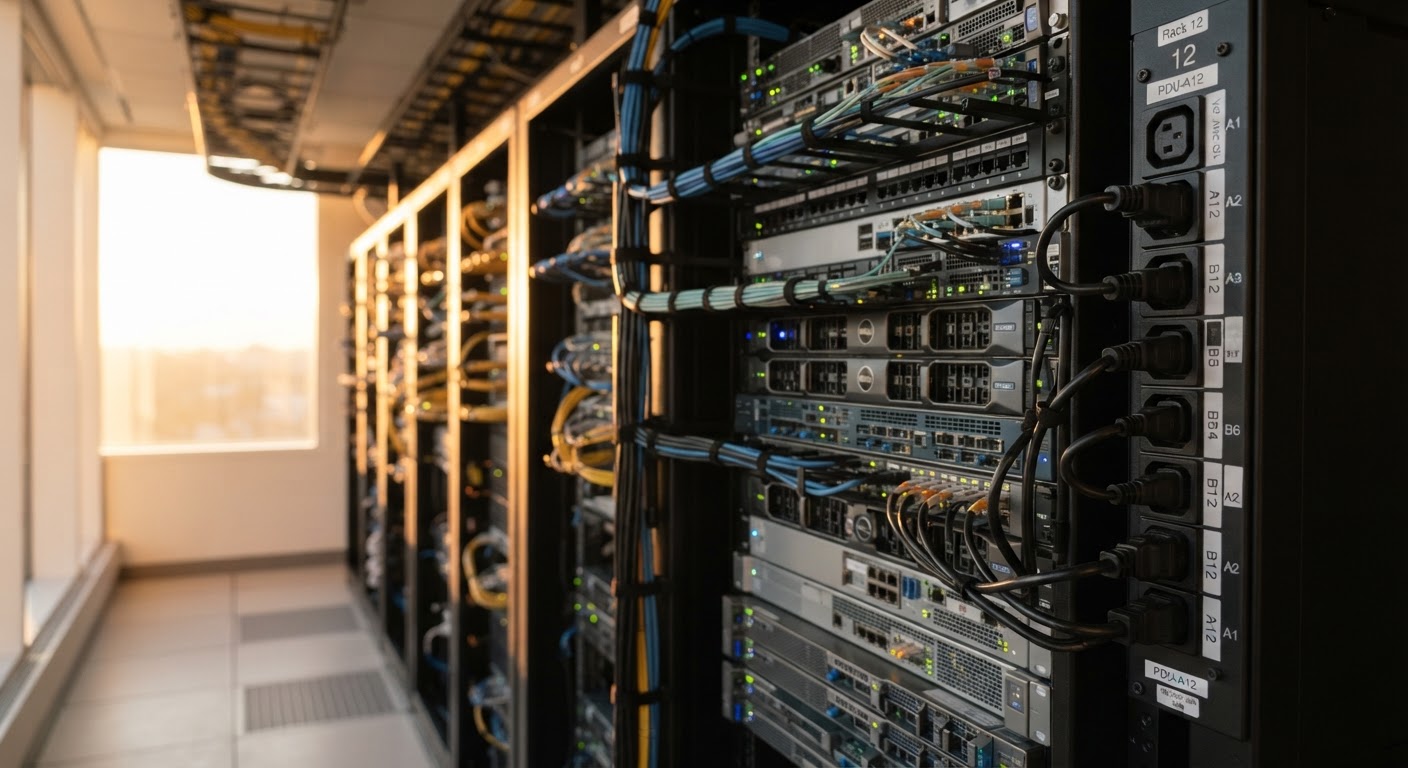
O rack deve ser dimensionado conforme espaço, peso, potência e manutenção. A altura disponível, normalmente medida em unidades de rack, é apenas o primeiro critério. Um servidor com várias aceleradoras pode ocupar poucas unidades e, ainda assim, consumir muito mais energia e liberar mais calor do que equipamentos convencionais.
O cálculo inicial de energia deve somar servidores, armazenamento, switches, equipamentos de segurança, sistemas de gerenciamento e uma margem para expansão. A potência informada pelo fabricante ajuda, mas não substitui a análise do consumo real em diferentes níveis de carga. O treinamento intenso, a inicialização de servidores e os picos de uso podem alterar a demanda do circuito.
Uma forma simples de organizar a estimativa é separar três valores, a carga prevista, a carga máxima possível e a capacidade reservada para crescimento. O projeto elétrico precisa considerar ainda a tensão, o número de circuitos, a distribuição entre fases, a redundância, a autonomia dos equipamentos de alimentação e a capacidade do quadro elétrico. Profissionais habilitados devem validar essas definições e compatibilizá-las com a instalação existente.
O uso de duas fontes de alimentação nos servidores não resolve, por si só, a redundância. É necessário verificar se cada fonte está ligada a caminhos elétricos realmente independentes, com PDUs, circuitos e sistemas de continuidade compatíveis. Se as duas fontes dependem do mesmo ponto de falha, a redundância existe apenas no papel.
Outro erro recorrente é preencher o rack até o limite físico e esquecer o espaço necessário para cabos, circulação de ar e retirada de componentes. A organização deve prever identificação, raio de curvatura dos cabos, acesso frontal e traseiro e possibilidade de manutenção sem deslocar equipamentos vizinhos.
Rede e armazenamento e o gargalo que aparece depois
Em clusters de IA, a rede precisa atender tanto ao tráfego de usuários quanto à comunicação entre servidores. Esse segundo fluxo, entre os próprios nós, pode ser decisivo durante o treinamento distribuído, quando eles trocam parâmetros e dados repetidamente. Uma rede dimensionada apenas pela conexão externa pode limitar o desempenho do cluster.
A escolha entre velocidades de 25, 100, 200 ou 400 GbE, entre outras possibilidades, depende do número de aceleradores, do desenho dos servidores, do padrão de comunicação e do orçamento. Não basta instalar switches de alta velocidade. Placas de rede, transceptores, cabos, portas dos servidores e configuração do software precisam ser compatíveis.
O armazenamento também deve ser analisado como parte do fluxo. Modelos, conjuntos de dados, checkpoints e arquivos temporários podem gerar leituras e gravações intensas. Um sistema rápido de armazenamento conectado a uma rede lenta continuará com desempenho limitado. Da mesma forma, usar armazenamento de alto desempenho para todos os dados pode elevar o custo sem melhorar aplicações que acessam os arquivos apenas ocasionalmente.
Na comparação dos componentes, vale observar os seguintes critérios e sinais de dimensionamento inadequado. Para os aceleradores, considere memória, desempenho por aplicação e consumo. Uma GPU subutilizada ou memória insuficiente para o modelo pode indicar um problema. Nos servidores, avalie CPU, memória, expansão e suporte aos aceleradores. Um processador ou uma memória que impeça o uso das GPUs também sinaliza um dimensionamento inadequado.
Para a rede, observe banda, latência, caminhos e comunicação entre nós. Um treinamento lento apesar da capacidade computacional disponível pode indicar um gargalo. No armazenamento, analise IOPS, vazão, capacidade e retenção. Se os dados não chegam aos servidores no ritmo necessário, o desempenho será limitado. Já no rack e na energia, considere potência, distribuição, espaço e redundância. Alertas elétricos, circuitos sobrecarregados ou manutenção difícil são sinais de atenção.
Essa análise não substitui testes. Um benchmark com uma carga próxima à aplicação real costuma revelar limitações que as especificações isoladas não mostram.
Refrigeração e localização definem a continuidade operacional
A refrigeração de um cluster de IA deve ser calculada a partir da potência térmica total, da densidade por rack e do comportamento da carga. Quase toda a energia consumida pelos equipamentos acaba convertida em calor no ambiente. Assim, aumentar a potência computacional sem revisar o sistema de climatização pode elevar a temperatura rapidamente e provocar redução de desempenho, desligamentos ou desgaste prematuro.
Em instalações de menor densidade, o resfriamento por ar pode ser suficiente, desde que haja capacidade compatível, distribuição adequada e corredores organizados. Em densidades mais altas, pode ser necessário avaliar soluções específicas, como contenção de corredores, aumento da vazão de ar ou tecnologias de refrigeração líquida. A escolha depende do servidor, do fabricante, da infraestrutura predial e das condições de manutenção.
Não basta medir a temperatura da sala em um único ponto. O ar que chega à entrada do rack pode estar dentro da faixa esperada, enquanto uma área superior ou traseira acumula calor. Sensores distribuídos, alertas de temperatura e umidade e acompanhamento das tendências ajudam a identificar problemas antes que causem falhas.
A localização deve considerar piso, acesso para equipamentos, peso concentrado, distância até quadros elétricos, rotas de cabos, ruído, ventilação e segurança física. Um espaço improvisado, próximo a fontes de poeira, umidade ou circulação intensa, pode reduzir a previsibilidade da operação. Também é necessário garantir que a equipe consiga fazer a manutenção sem bloquear passagens ou desmontar parte da instalação.
O cálculo térmico deve ser validado em campo. A capacidade nominal do ar-condicionado não significa, por si só, que há capacidade disponível para o cluster. A temperatura externa, a distribuição do ar, a eficiência do sistema e as demais cargas da sala interferem no resultado.
Segurança, operação e crescimento do cluster
Um cluster de IA concentra dados, modelos e credenciais que podem ter valor operacional ou estratégico. A proteção começa pelo controle de acesso físico aos racks e pela separação lógica das redes. Também envolve gestão de identidades, registro de eventos, atualização dos sistemas, cópias de segurança e definição clara de quem pode iniciar cargas de alto consumo.
O crescimento deve ser planejado antes da primeira compra. É útil reservar espaço físico, portas de rede, capacidade elétrica, margem térmica e posições para sensores. Essa reserva não significa instalar tudo de uma vez, mas evitar que a expansão exija refazer a infraestrutura básica.
A ampliação costuma ser indicada quando a demanda permanece perto da capacidade disponível, as filas de processamento prejudicam aplicações importantes ou o tempo de treinamento deixa de atender ao planejamento. Comprar novos aceleradores antes de eliminar gargalos de dados, rede ou software pode aumentar o custo sem entregar um ganho proporcional.
Um critério prático é acompanhar, ao longo do tempo, a utilização das GPUs, a memória ocupada, a vazão da rede, a latência do armazenamento, o consumo elétrico, a temperatura e as filas de execução. Esses indicadores ajudam a distinguir falta de equipamento de má distribuição de carga ou configuração inadequada.
O custo também deve ser avaliado em duas camadas. O investimento inicial inclui servidores, aceleradores, armazenamento, switches, racks, alimentação e adequações físicas. O custo recorrente envolve energia, refrigeração, manutenção, licenças quando aplicáveis, espaço e equipe. Um equipamento mais barato pode exigir mais energia ou oferecer pouca margem de expansão. Já uma configuração com maior capacidade pode ser desnecessária para uma carga pequena. A comparação precisa considerar o uso real e o horizonte de crescimento.
Quando o projeto exige avaliação especializada
A avaliação técnica ganha importância quando há alta densidade de potência, necessidade de redundância, alteração do sistema elétrico, refrigeração perto do limite ou integração com ambientes já ocupados. Nesses casos, decisões tomadas apenas por catálogo podem ignorar restrições físicas que aparecem somente na instalação.
Também é importante diferenciar o monitoramento de um equipamento da análise do ambiente. Um alerta de servidor desligado informa que o problema já aconteceu. Sensores ambientais, controle de acesso, organização dos ativos e histórico de eventos ajudam a acompanhar as condições que antecedem a indisponibilidade, desde que exista uma rotina para responder aos alertas.
É nesse ponto que racks inteligentes podem contribuir para uma operação mais controlada. Os Smart Cabinets, da Smart Cabinet, combinam controle de acesso, monitoramento de temperatura e umidade, alertas personalizados e visibilidade dos eventos do ambiente. A aplicação deve ser definida conforme o projeto, mas esses recursos podem apoiar tanto pequenos CPDs quanto infraestruturas mais exigentes que precisam de rastreabilidade e acompanhamento contínuo.
Para um cluster de IA, a escolha do rack não deve ser separada da análise de energia, rede, refrigeração e expansão. Uma solução sob medida permite relacionar as características do equipamento ao espaço disponível e à rotina da equipe de TI, em vez de tratar o gabinete como um item isolado.
O melhor momento para revisar o planejamento é antes da compra dos servidores e novamente antes de cada expansão. Com aplicações bem definidas, participação das áreas certas, margem física e acompanhamento ambiental, o cluster tende a crescer de forma mais previsível. Esses critérios ajudam a comparar propostas e discutir a infraestrutura com a Smart Cabinet pelo telefone ou WhatsApp, no número (11) 95606-3651, caso seja necessário avaliar racks inteligentes e soluções personalizadas para o ambiente.
Não perca mais tempo: fale AGORA com um especialista!
Tire suas dúvidas sobre rack inteligente em minutos e descubra como podemos ajudar você ainda hoje. Atendimento rápido e direto pelo WhatsApp.
QUERO FALAR NO WHATSAPP