Índice:
- Como evitar desligamentos inesperados em servidores críticos
- Quais causas provocam uma parada não planejada?
- Quais sinais antecipam uma falha no servidor?
- Que medidas reduzem o risco de desligamento?
- Como escolher entre monitoramento, redundância e manutenção?
- O que fazer depois de um desligamento inesperado?
- Como o rack inteligente ajuda na prevenção?
Um servidor crítico raramente desliga sem qualquer sinal. Antes da interrupção, podem surgir alertas de temperatura, quedas breves de energia, reinicializações isoladas, ruídos anormais, erros de disco ou mudanças recentes na configuração. O problema é que esses sinais costumam ser vistos como ocorrências pontuais até que uma falha interrompa sistemas, aplicações e serviços dependentes.
Como evitar desligamentos inesperados em servidores críticos exige uma combinação de diagnóstico, monitoramento contínuo, manutenção e capacidade de resposta. A prevenção não depende apenas do servidor. Também envolve a instalação elétrica, a climatização, os componentes de hardware, os procedimentos da equipe e o controle de acesso ao ambiente.
Como evitar desligamentos inesperados em servidores críticos
Para evitar desligamentos inesperados em servidores críticos, é necessário identificar as causas de risco antes que interrompam a operação, monitorar continuamente a energia e o ambiente, planejar a manutenção e preparar uma resposta a falhas. Nenhuma medida isolada elimina todos os riscos, mas a combinação de inspeções, redundância, alertas e procedimentos reduz a probabilidade e o impacto de uma parada.
O primeiro passo é distinguir um desligamento real de uma simples reinicialização causada por atualização, erro de sistema ou intervenção administrativa. Logs do sistema operacional, registros de gerenciamento do servidor, alarmes de energia e histórico de temperatura ajudam a reconstruir a sequência dos acontecimentos. Sem essa análise, a equipe pode trocar um componente saudável e deixar a causa original sem solução.
Também é importante definir responsabilidades. A equipe de infraestrutura costuma investigar energia, climatização, hardware e conectividade. O time de sistemas avalia serviços, atualizações e dependências. Já a gestão de TI decide prioridades, níveis de redundância e procedimentos de contingência. Em ambientes menores, uma mesma pessoa pode acumular funções, mas as responsabilidades ainda precisam estar claras.
Quais causas provocam uma parada não planejada?
As causas mais comuns estão relacionadas a energia, calor, hardware, software e manutenção inadequada. O mesmo sintoma, um servidor desligado, pode resultar de problemas muito diferentes, e cada um exige uma resposta própria. A investigação deve começar pelo momento exato da falha e pelos eventos registrados nos minutos ou nas horas anteriores.
Falhas de energia incluem interrupções da concessionária, oscilações, quedas de tensão, circuitos sobrecarregados, conectores frouxos e problemas em nobreaks, baterias ou geradores. Um nobreak descarregado ou dimensionado sem considerar a carga real pode criar uma falsa sensação de proteção. Não basta ter o equipamento. É preciso verificar autonomia, estado das baterias, alarmes, capacidade e manutenção.
O superaquecimento também merece atenção. Servidores produzem calor continuamente, e a temperatura interna pode subir quando o ar-condicionado perde desempenho, os filtros ficam obstruídos, as entradas de ar são bloqueadas ou o fluxo entre corredores é inadequado. Poeira acumulada, cabos mal organizados e portas abertas podem prejudicar a circulação de ar e acelerar o desgaste dos componentes.
Entre os pontos de risco no hardware estão fontes de alimentação, ventiladores, discos, memória, controladoras e placas. Erros intermitentes, ruídos, aumento de temperatura, falhas de leitura e reinicializações aleatórias podem surgir antes de uma parada definitiva. O diagnóstico também deve considerar componentes aparentemente secundários. Uma fonte instável ou uma ventoinha com rotação irregular pode derrubar o equipamento inteiro.
Há ainda falhas causadas por software e intervenção humana. Atualizações sem janela de manutenção, drivers incompatíveis, configurações alteradas sem registro, desligamentos forçados e procedimentos executados no equipamento errado são exemplos recorrentes. Manutenção inadequada não significa apenas deixar de limpar ou trocar peças. Também envolve não documentar mudanças, não testar restaurações e não revisar os serviços realizados.
Quais sinais antecipam uma falha no servidor?
Os sinais que antecedem uma falha podem aparecer no próprio servidor, na infraestrutura ou nos sistemas monitorados. Alertas repetidos de temperatura, fonte ou armazenamento, reinicializações sem causa clara, lentidão associada a erros de disco, perda de comunicação com sensores e oscilações de energia devem ser investigados, não tratados como avisos sem urgência.
Um alerta isolado pode ser um falso positivo. A repetição, a tendência de piora ou a coincidência entre eventos aumentam o risco. Por exemplo, uma elevação de temperatura em determinado período, acompanhada pelo aumento da rotação das ventoinhas e por falhas de desempenho, merece mais atenção do que uma leitura momentânea sem outros sintomas.
Temperatura acima do padrão do ambiente ou aumento gradual ao longo dos dias pode indicar problema de climatização, obstrução do fluxo de ar ou carga maior do que a prevista.
Reinicializações inesperadas, telas de erro e registros de falha de hardware podem apontar para memória, fonte, armazenamento, firmware ou alimentação instável.
Alarmes de nobreak, quedas breves de comunicação e registros de perda de energia sugerem que a investigação deve incluir o circuito elétrico, não apenas o servidor.
Ruídos incomuns, vibração, ventiladores operando continuamente em alta velocidade e discos com erros de leitura justificam uma inspeção técnica antes de uma parada mais grave.
Acessos administrativos sem registro claro, alterações recentes e manutenção fora da janela prevista indicam risco operacional e exigem uma revisão dos procedimentos.
O valor desses sinais está na correlação. Um sistema de monitoramento que registra apenas a temperatura, sem relacioná-la à energia, aos acessos e aos eventos do servidor, deixa parte da história escondida. A análise fica mais confiável quando uma linha do tempo reúne as mudanças, os acessos ao rack e os alarmes registrados antes da interrupção.
Que medidas reduzem o risco de desligamento?
A prevenção começa com uma base física confiável. O ambiente deve ter alimentação compatível com a carga, proteção contra oscilações, aterramento adequado e climatização estável. A avaliação precisa considerar o uso real, a expansão prevista e a manutenção disponível. Instalar equipamentos sem revisar essa base apenas adia o problema.
A redundância também é importante, mas não significa duplicar tudo automaticamente. Fontes redundantes, circuitos independentes, armazenamento protegido e caminhos alternativos podem manter o serviço ativo quando um componente falha. Porém, a redundância só funciona se os caminhos forem realmente independentes. Duas fontes ligadas ao mesmo circuito defeituoso não oferecem a proteção esperada.
O monitoramento deve acompanhar, no mínimo, energia, temperatura, umidade, estado dos equipamentos e eventos de acesso quando esses fatores afetarem a continuidade. Os alertas precisam chegar às pessoas responsáveis e seguir critérios de prioridade. Um painel cheio de notificações sem classificação pode esconder justamente o alarme que exige intervenção imediata.
A manutenção deve combinar inspeção física, análise de logs, testes de componentes e revisão de configurações. A periodicidade depende da criticidade, do ambiente, da idade dos equipamentos, da carga e das recomendações dos fabricantes. Em muitas operações, faz sentido acompanhar os alertas diariamente, realizar inspeções visuais periódicas e programar revisões técnicas conforme o risco. O calendário, porém, não deve substituir a resposta a um sinal anormal.
Uma inspeção visual simples pode revelar cabos pressionando entradas de ar, portas abertas, acúmulo de poeira, equipamentos fora de posição, indicadores de alerta e obstáculos à circulação. Ela não substitui a avaliação técnica, mas ajuda a identificar pequenos problemas antes que provoquem uma falha.
Como escolher entre monitoramento, redundância e manutenção?
A prioridade depende do tipo de risco que ameaça a operação. O monitoramento é mais útil quando faltam visibilidade e tempo de resposta. A redundância ganha peso quando uma falha única pode interromper um serviço essencial. Já a manutenção é decisiva quando há sinais de desgaste ou histórico de incidentes. Em ambientes críticos, essas medidas se complementam, mas o investimento deve começar pelo ponto de maior risco.
Quedas breves e reinicializações pedem uma análise inicial da alimentação, do nobreak, dos circuitos e dos registros de energia. As medidas preventivas podem incluir testes controlados, alertas e avaliação independente dos caminhos de energia.
Temperatura elevada ou instável exige verificar a climatização, o fluxo de ar, a poeira e o posicionamento. O monitoramento ambiental, as inspeções e a correção da circulação ajudam a prevenir novas ocorrências.
Erros de disco ou memória pedem análise de logs, diagnóstico do fabricante e verificação da integridade dos dados. A prevenção pode envolver substituição planejada, cópias válidas e componentes redundantes, quando aplicável.
Falhas após intervenções exigem revisar mudanças, permissões, firmware e procedimentos. Uma janela de manutenção, o registro de acesso e a validação após o serviço ajudam a reduzir esse risco.
A escolha também deve considerar o impacto da parada do servidor. Uma aplicação pode tolerar alguns minutos de indisponibilidade. Outra pode causar perdas financeiras, interrupção operacional ou afetar vários sistemas dependentes. Quanto maiores as consequências, mais importante é combinar alertas antecipados, redundância adequada e um plano de recuperação testado.
O custo não deve ser avaliado apenas pelo preço do equipamento. Uma opção barata, mas difícil de monitorar ou manter, pode aumentar o tempo de diagnóstico. Da mesma forma, uma arquitetura muito complexa para uma sala técnica pequena pode criar dependências difíceis de administrar. A decisão mais segura corresponde à criticidade real e à capacidade operacional disponível.
O que fazer depois de um desligamento inesperado?
Após uma parada, a prioridade é proteger pessoas, equipamentos e dados antes de tentar ligar tudo novamente. A equipe deve confirmar as condições elétricas e ambientais, verificar se há cheiro de queimado, sinais de aquecimento, ruídos ou alarmes ativos e registrar o horário e o contexto do evento. Reinicializações repetidas sem diagnóstico podem agravar uma falha de hardware ou corromper dados.
Em seguida, é preciso preservar os registros do sistema, os alarmes de energia, temperatura, umidade e nobreak, os dados de controle de acesso e as alterações recentes. A pergunta mais útil não é apenas se o servidor voltou, mas o que aconteceu imediatamente antes da queda. Esse histórico ajuda a distinguir uma falha de energia de um problema na fonte, superaquecimento, atualização ou intervenção indevida.
O retorno deve seguir a prioridade dos serviços, não necessariamente a ordem física dos equipamentos. É preciso considerar dependências de rede, armazenamento, autenticação e banco de dados. Em alguns casos, iniciar todos os servidores ao mesmo tempo sobrecarrega a alimentação ou causa erros em aplicações que dependem de outros serviços.
Depois da recuperação, a equipe precisa corrigir a causa e atualizar os procedimentos. Se a origem foi uma bateria degradada, apenas religar o servidor não resolve. Se houve superaquecimento, limpar o equipamento sem corrigir o fluxo de ar mantém o risco. Se uma mudança causou a parada, também é necessário rever o processo de aprovação e validação.
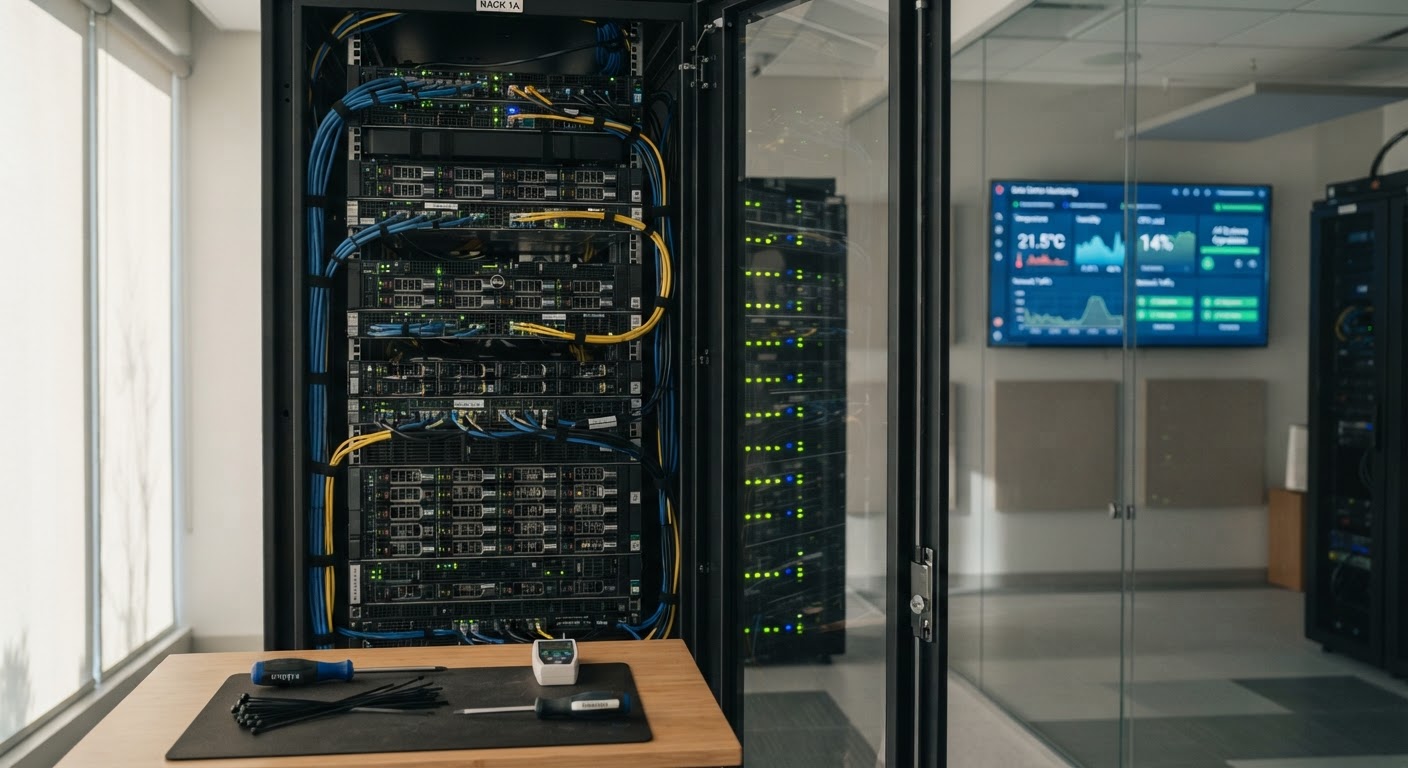
Como o rack inteligente ajuda na prevenção?
O rack inteligente pode apoiar a prevenção ao reunir controle de acesso, monitoramento ambiental e alertas em tempo real no ambiente de infraestrutura. Essa combinação ajuda a relacionar uma alteração física a condições de temperatura e umidade ou a outros eventos registrados, facilitando a identificação de riscos antes que provoquem indisponibilidade.
Em uma sala técnica ou datacenter, saber que um gabinete foi acessado não substitui o diagnóstico, mas acrescenta contexto. O registro de eventos ajuda a verificar se uma tampa foi aberta, se houve intervenção durante uma janela planejada ou se uma alteração coincidiu com o início de um problema. Já o monitoramento de temperatura e umidade revela mudanças que poderiam passar despercebidas em uma inspeção ocasional.
Os Smart Cabinets, da Smart Cabinet, foram desenvolvidos para apoiar esse tipo de gestão em ambientes críticos de TI. Eles oferecem controle de acesso, monitoramento de temperatura e umidade, alertas personalizados e visibilidade dos eventos. A aplicação pode atender pequenos CPDs, salas técnicas e estruturas maiores, conforme as necessidades do projeto e a rotina da equipe.
Evitar desligamentos inesperados não significa prever cada falha, mas reduzir os pontos cegos. Quando energia, ambiente, hardware, manutenção e acesso são acompanhados como partes do mesmo processo, os primeiros sinais ganham significado e a resposta tende a ser mais rápida. Essa análise ajuda a revisar a infraestrutura atual e a decidir onde monitoramento, redundância ou apoio especializado podem reduzir o impacto da próxima ocorrência.
Não perca mais tempo: fale AGORA com um especialista!
Tire suas dúvidas sobre rack inteligente em minutos e descubra como podemos ajudar você ainda hoje. Atendimento rápido e direto pelo WhatsApp.
QUERO FALAR NO WHATSAPP