Índice:
- Como funciona um serviço de monitoramento para racks
- Quais falhas o monitoramento ajuda a antecipar
- O que avaliar antes de escolher a solução
- Alertas úteis dependem de contexto e procedimento
- Erros comuns que reduzem o valor do monitoramento
- Quando o serviço faz mais sentido na operação
- Monitoramento como parte da gestão do rack
Uma falha em um rack raramente começa no momento em que o equipamento para. Antes disso, podem surgir aumento gradual de temperatura, umidade fora do padrão, acesso não previsto ou alterações que passam despercebidas durante a rotina da equipe. Quando o problema é percebido apenas pelo impacto no serviço, o tempo de reação já ficou menor e o diagnóstico tende a ser mais difícil.
Um serviço de monitoramento para racks ajuda a acompanhar essas condições continuamente, registrar eventos e emitir alertas antes que uma alteração ambiental ou de segurança evolua para uma indisponibilidade. A eficiência, porém, não depende apenas de instalar sensores: é preciso monitorar o que realmente ameaça a operação, configurar alertas úteis e transformar os dados em uma rotina de resposta.
Como funciona um serviço de monitoramento para racks
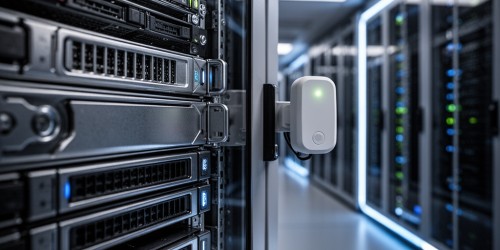
Um serviço de monitoramento para racks reúne sensores, regras de alerta, registro de eventos e acompanhamento das condições do ambiente técnico. A solução coleta informações como temperatura, umidade e acessos, compara os dados com limites definidos para aquela operação e sinaliza alterações que exigem investigação ou ação.
A lógica parece simples, mas o valor está na continuidade. Uma leitura isolada pode mostrar que o ambiente está normal naquele instante; o histórico revela se a temperatura vem subindo ao longo do dia, se a umidade oscila em determinados horários ou se há acessos recorrentes fora da rotina. Essa visão ajuda a diferenciar um incidente pontual de um padrão que merece correção.
Em uma estrutura mais organizada, o monitoramento também registra quando o alerta surgiu, qual condição o provocou e o que foi feito depois. Essa rastreabilidade reduz a dependência da memória dos profissionais e facilita a análise posterior, especialmente quando diferentes equipes cuidam da infraestrutura, da segurança física e da operação de TI.
O serviço pode ser aplicado em datacenters, salas técnicas, CPDs e departamentos de TI. A quantidade de pontos monitorados e os limites de alerta dependem do projeto, da disposição dos racks, da circulação de ar, dos equipamentos instalados e do nível de criticidade da operação.
Quais falhas o monitoramento ajuda a antecipar
O monitoramento não elimina todos os riscos da infraestrutura, mas reduz o intervalo entre o início de uma anomalia e a tomada de decisão. Esse intervalo costuma ser decisivo quando o ambiente abriga servidores, equipamentos de rede, sistemas de armazenamento ou outros ativos que não podem ser tratados como elementos isolados.
A temperatura elevada é um dos sinais mais conhecidos. Ela pode estar relacionada à carga dos equipamentos, à obstrução da circulação de ar, à distribuição inadequada dos ativos ou a uma condição irregular do sistema de climatização. O alerta não substitui a análise técnica, mas indica que a equipe deve investigar antes que o calor afete o desempenho ou a vida útil dos componentes.
A umidade também merece atenção. Níveis inadequados podem contribuir para condensação, corrosão e degradação de partes sensíveis, enquanto um ambiente excessivamente seco pode favorecer descargas eletrostáticas em determinadas condições. O limite aceitável varia conforme o ambiente e as orientações dos fabricantes; o importante é acompanhar tendência, duração e contexto, não apenas reagir a uma leitura fora do esperado.
O controle de acesso acrescenta uma camada diferente de proteção. Saber que uma porta foi aberta, em que horário e por qual credencial ajuda a investigar intervenções, manutenções e acessos que não estavam previstos. O registro não deve ser tratado como prova automática de um incidente, mas como uma evidência operacional que precisa ser relacionada à escala de trabalho e às autorizações existentes.
Outro ganho está na percepção de problemas que não provocaram uma falha imediata. Um rack pode continuar funcionando enquanto apresenta oscilações ambientais, intervenções frequentes ou sinais de desorganização. A repetição desses eventos é relevante porque indica que a infraestrutura está operando com pouca margem de segurança.
O que avaliar antes de escolher a solução
A escolha deve começar pelo risco que precisa ser controlado, e não pela quantidade de recursos apresentada em uma demonstração. Uma operação que precisa apenas acompanhar temperatura terá necessidades diferentes de um ambiente que também exige controle de acesso, histórico detalhado e alertas para diferentes responsáveis.
O primeiro ponto é verificar quais variáveis podem ser acompanhadas e em que posição os sensores serão instalados. Medir a temperatura em um único local talvez não represente o comportamento de um rack com equipamentos que liberam calor em pontos distintos. O projeto precisa considerar a circulação de ar, a altura dos ativos, a proximidade de fontes de calor e a facilidade de manutenção dos sensores.
O segundo é observar como os alertas funcionam. Um aviso genérico, sem limite configurável, prioridade ou responsável definido, pode gerar tanto atraso quanto excesso de notificações. Alertas demais tendem a ser ignorados; alertas de menos podem deixar um evento relevante sem resposta. A configuração deve separar situações que exigem intervenção imediata daquelas que pedem apenas acompanhamento.
Também vale avaliar a qualidade do histórico. Dados atuais mostram o estado do ambiente; registros anteriores permitem identificar recorrência, comparar períodos e entender se uma ação resolveu o problema. Sem histórico, a equipe fica limitada a investigar o que está acontecendo agora, muitas vezes depois que o impacto já apareceu.
Uma análise prática costuma considerar:
- cobertura de monitoramento: quais racks, compartimentos e áreas serão acompanhados, e se a distribuição dos sensores representa o ambiente real;
- regras de alerta: quais limites podem ser configurados, como os níveis de prioridade são definidos e quem recebe cada aviso;
- rastreabilidade: se acessos, alterações e alertas ficam registrados com data e hora para apoiar a investigação;
- rotina operacional: como a equipe reconhece o evento, registra a resposta e verifica se a condição voltou ao normal;
- adequação ao crescimento: se a solução pode acompanhar mudanças na ocupação dos racks sem exigir uma reconstrução completa do projeto.
Esse conjunto de critérios é mais útil do que comparar apenas a quantidade de sensores ou a aparência do painel. O recurso só produz valor quando se encaixa na rotina de quem precisa agir.
Alertas úteis dependem de contexto e procedimento
Um alerta eficiente não é simplesmente uma mensagem enviada sempre que um valor muda. Ele combina um limite coerente, um tempo de permanência, uma prioridade e uma pessoa ou equipe responsável pela resposta. Sem esses elementos, a tecnologia pode registrar o problema, mas não necessariamente acelerar a solução.
Uma elevação rápida de temperatura merece tratamento diferente de uma alteração pequena e gradual. A primeira pode indicar um evento repentino; a segunda talvez revele uma tendência associada à carga dos equipamentos ou à climatização. O tempo de permanência também importa: um pico breve não tem o mesmo significado de uma condição que permanece por vários minutos, embora a definição dos limites dependa da aplicação e das recomendações técnicas pertinentes.
A cadeia de resposta precisa ser combinada antes da ocorrência. Se o aviso chega a uma pessoa que está fora do turno, não há cobertura definida ou ninguém sabe quem deve verificar o rack, o alerta perde parte da utilidade. A operação deve estabelecer quem faz a triagem, quem pode acessar a sala técnica, quem aciona outras equipes e como o encerramento do evento será registrado.
Há ainda uma diferença entre notificar e explicar. Um bom registro deve ajudar a responder perguntas como: o evento começou quando, qual rack foi afetado, a condição foi isolada ou se repetiu, houve acesso próximo ao horário e quais medidas foram tomadas? Essas respostas reduzem o tempo gasto reconstruindo a ocorrência a partir de mensagens espalhadas.
Erros comuns que reduzem o valor do monitoramento
Um dos erros mais frequentes é instalar a solução sem revisar a rotina do ambiente. O sensor passa a coletar dados, mas ninguém define limites, responsáveis ou periodicidade de análise. Nesse caso, a empresa tem informação, porém não tem um processo para convertê-la em decisão.
Outro problema é usar o mesmo parâmetro para todos os racks. Ambientes com diferentes tipos de equipamentos, ocupação e circulação de ar podem apresentar comportamentos distintos. A padronização facilita a administração, mas não deve apagar diferenças que alteram o risco.
Também é arriscado posicionar sensores apenas onde a instalação é mais conveniente. Uma leitura distante do ponto crítico pode criar uma falsa sensação de controle. A posição precisa ser analisada junto com o fluxo de ar, a concentração de equipamentos e os locais onde uma anomalia tende a aparecer primeiro.
O excesso de notificações produz um efeito silencioso: a equipe começa a tratar os alertas como ruído. Antes de ampliar a quantidade de avisos, convém revisar quais eventos realmente exigem ação, quais podem ser agrupados e quais precisam de acompanhamento histórico.
Por fim, monitoramento não substitui manutenção, organização física, climatização adequada ou controle de mudanças. A ferramenta mostra sinais e registra ocorrências; a correção depende de diagnóstico e de medidas compatíveis com o ambiente. Um painel com dados normais não compensa uma infraestrutura sem revisão técnica ou com documentação desatualizada.
Quando o serviço faz mais sentido na operação
O monitoramento tende a ser especialmente útil quando a indisponibilidade de um ativo pode interromper processos importantes, quando a sala técnica não permanece sob observação contínua ou quando há mais de uma equipe envolvida na infraestrutura. Também ajuda em ambientes que cresceram de forma gradual e já não permitem perceber alterações apenas por inspeção visual.
Em uma estrutura pequena, a solução pode começar com um conjunto restrito de variáveis e racks prioritários. Em uma operação maior, a necessidade de segmentar alertas, manter histórico e controlar acessos costuma ser mais evidente. O ponto de partida não deve ser o tamanho da empresa, mas a consequência de uma falha e a capacidade real de detectar o problema a tempo.
A implementação fica mais consistente quando parte de um diagnóstico: quais ativos são críticos, quais eventos já ocorreram, quais áreas têm acesso controlado, como a equipe recebe chamados e que informações faltam durante uma investigação. A partir daí, torna-se possível definir o que será medido, quais alertas são necessários e quais recursos seriam apenas conveniência.
Esse cuidado também evita a expectativa de que o monitoramento resolva sozinho uma infraestrutura desorganizada. Se cabos, equipamentos e portas não estão identificados, até um alerta correto pode levar mais tempo para ser interpretado. Visibilidade digital e organização física se reforçam; uma não elimina a necessidade da outra.
Monitoramento como parte da gestão do rack
Prevenir falhas críticas exige sair da lógica de observar o rack apenas quando algo para. Temperatura, umidade, acesso e histórico formam uma base de informação que ajuda a encontrar desvios antes que eles se transformem em indisponibilidade, mas a qualidade do resultado depende da configuração e da resposta adotadas pela operação.
O Smart Cabinet trabalha justamente com essa visão de racks inteligentes para ambientes de TI, combinando controle de acesso, monitoramento ambiental e registro de eventos. A proposta pode ser considerada em datacenters, salas técnicas e CPDs que precisam de mais visibilidade sobre seus ativos e de uma gestão compatível com o nível de criticidade da infraestrutura.
Antes de escolher um serviço de monitoramento para racks, vale documentar os riscos atuais, observar a rotina de acesso, identificar os pontos mais sensíveis e definir quem responderá a cada tipo de alerta. Essa preparação torna a decisão mais segura e evita investir em recursos que não serão usados. Em infraestrutura crítica, detectar cedo é importante; saber o que fazer com a informação é o que transforma o alerta em prevenção.
Não perca mais tempo: fale AGORA com um especialista!
Tire suas dúvidas sobre rack inteligente em minutos e descubra como podemos ajudar você ainda hoje. Atendimento rápido e direto pelo WhatsApp.
QUERO FALAR NO WHATSAPP